
其他
完整应用

deepseek-harness
deepseek-ai
DeepSeek Harness: Everything is a Plugin.
PROJECT TOPICS
PROJECT README
不替模型思考,只让它手边的事实到位。
给 DSH Desktop 加四样东西——三层能力,加一块仪表盘:
| 层 | 管什么 | 一句话 |
|---|---|---|
| 纪律层 | 这一轮该怎么干 | 判断请求类型、划清"能不能动手"的边界、交付前对账 |
| 方法层 | 干活的产出物 | 契约 / 改动台账 / 假设台账 / 设计决策 / 项目知识——可检查、可跨会话 |
| 仪表盘 | 到底有没有用 | 路由判定、触发器命中、外部结果信号落盘,lume_metrics 随时可查 |
| 人设层 | 用什么风格说话 | 从真实素材蒸馏具名角色,长期记忆与风格随对话演进 |
约束按需注入:闲聊轮不会背上整份工作协议的成本。人设只影响自然语言表达,不介入代码、命令与工具调用的结果——你选"不使用人设"时,纪律层照样生效。
在会话里补上"事实到位"这一步。 它不替模型思考,只让模型手边的事实到位;约束按需注入,闲聊轮不额外加 token。(插件市场简介是本段的精简版——市场只放一句话定位与四组短句,细节留在本文。)
P0、user_id 这类)首次出现要用一短句说明它是什么,讲解只答三问(做了什么 / 凭什么说它对 / 还剩什么风险)。lume-metrics.jsonl,lume_metrics 可查触发器效能(口径为命中后 3 轮内出现真验证命令或载具从无到有,明确标注观察性;无机械口径的标未判定且不计入分母)。(下面用一个跟你业务无关的小例子:一个自己写着玩的跑步记录 App——单页前端加一个本地 SQLite。)
同一个需求:「给跑步记录加个『配速』列,历史数据也要补算」。
没有 Lume:它直接改了列表页那个表格。你问"迁移脚本写了吗",它说"已处理"——但它从没打开过建表那一份。你出门跑了半小时步,回来换个窗口继续,它又问你"这个项目怎么启动"。上下文撑满以后,进度就留在那个窗口里了。
有 Lume:
lume_metrics 会告诉你这一路的判定、命中与纠正率。它不做的事:
前置:已安装 DSH Desktop。
# npm(推荐)
dsh plugin add lume-dsh-plugin

# GitHub(备选)
dsh plugin add github:cayan0x/Lume#v<版本>   # 例如 v0.8.2

# 指定版本 / 最新
dsh plugin add lume-dsh-plugin@<版本>       # 例如 0.8.2
dsh plugin add lume-dsh-plugin@latest升级:重复执行同一条命令即可。若当初是用本地源码目录装的(依赖里是 link:),在源码目录执行:
git pull && npm install --legacy-peer-deps && npm run build装完必须完全重启 DSH(含托盘进程)——插件在宿主启动时加载,DSH 没有热重载。
每一轮先用这一句话 + 最近几轮轨迹判定请求类型,判定结果与命中的判据都写进注入块(也进度量):
| 模式 | 允许做什么 |
|---|---|
| 问答 | 直接回答;只读核实该做就做,不改文件、不替你做决定 |
| 查找 | 收集并区分已知 / 未知 / 推断;未经授权不改外部状态 |
| 讨论 | 比较选项、取舍与风险;不把探讨中的方案当成已定方案 |
| 诊断 | 说明现象、证据、根因与验证办法;除非你明确要求修复,不越权动手 |
| 执行 | 确认目标与完成标准,做最小变更;交付时列清已完成 / 已验证 / 未验证 / 残留副作用 |
轨迹只在证据足够时补判:纠正后按被纠正前那句话重算、在途任务对承接式追问有粘性、连问两句不算任务;带了疑问特征的句子一律不抬档。证据不足时回落到单句判定,绝不猜。
进入执行后还有阶段推进(answer → research → discuss → diagnose → execute → verify → deliver),阶段决定这一轮是"先给方案"还是"可以动手"。
| 核对 | 什么时候响 | 每会话上限 |
|---|---|---|
| 引用核对 | 回答里写了 文件:行,但这段本次没打开过 |
3 |
| 断言核对 | 对没见过的符号下"没映射 / 不存在 / 不支持"这类否定断言 | 2 |
| 需求漂移 | 有契约在手,进展却偏离了契约的判据(含压缩之后) | 2 |
| 覆盖核对 | 写出文档产物之后:把需求原句与交付物里的句子并列对账 | 2 |
| 提问核对 | 一轮抛出超过 2 条「待你定」,或问题带着"我没查 / 我猜" | 2 |
| 载具缺口 | 已经动了代码,但契约与设计都还空着 | 2 |
| 上下文预警 | 上下文占用到 75% / 90% | 3 |
| 度量自校 | 本会话路由被反复纠正(≥2 次) | 2 |
上限不是"省着用",是防噪音:同一个提醒反复顶,模型会开始躲词而不是解决问题。所以每个槽有自己的用量上限与冷却,多数槽还有"清空条件"——你补上了它就不再提。
协议文本管不了"在压力下不执行"——实测症状是连续几十次广度探查不收敛、连续十几次改动不验证、在同一个坏环境上撞十几次。这类症状是轨迹的,所以判据也在轨迹上:
| 触发器 | 判据(可配阈值) | 命中后给什么 |
|---|---|---|
converge |
连续只读探查 ≥ 12 步仍无产出 | 停止撒网,先复述链路并落台账 |
verify-as-you-go |
连续改动 ≥ 4 步(或台账未验证项 ≥ 4) | 先跑一次最小验证,再把台账推进到 verified |
dead-path |
同一验证连续失败 ≥ 3 次 | 环境类给"验证降级阶梯",其余要求先分清是哪类原因,并把结论记进假设台账 |
hypothesis-stale |
诊断轮出现验证失败,但假设台账没更新 | 把失败归因落成假设,标出下一步验哪条 |
contract-missing |
已经动手,但还没写契约 | 补一份契约(目标 / 范围 / 数量 / 判据 / 非目标) |
design-missing |
设计型任务摸了 ≥ 6 处代码仍无设计记录 | 写lume_design:决策点 / 选择 / 放弃理由 / 影响面 |
criteria-drift |
有契约,且距上次对账 ≥ 3 轮(或刚压缩过) | 拿契约逐条对账,防止判据随进展漂移 |
knowledge-capture |
工具步数 ≥ 20 且本会话还没提醒过 | 若有稳定事实(命令 / 链路 / 约定 / 死路)就记下来 |
规矩:一次只顶一条(按紧急度排序,同时堆三条会互相稀释)、每类每轮最多一次、同类两轮内不重复、文本里带具体数字("已连续 14 次只读探查")——让提醒可被核对,而不是空洞训话。
模型丢的通常不是"不知道要量化",而是没有一个地方放量化结果。任务侧八个:
| 工具 | 做什么 |
|---|---|
lume_contract |
任务契约:目标 / 范围 / 数量(先估后回填)/ 完成判据 / 非目标 / 待确认 |
lume_change |
改动台账:改什么 → 为什么 → 怎么验证的 → 状态;只推进状态时可只传 target + status |
lume_hypothesis |
假设台账:open / testing / confirmed / excluded;含被推翻的已排除项 |
lume_design |
设计决策:决策点 → 选择 → 被放弃的方案与理由 → 影响面 |
lume_project_note |
记一条稳定的项目事实(按工作目录跨会话累积) |
lume_project_forget |
按编号删掉一条过时或记错的项目知识 |
lume_forget |
撤销一条记录(改动 / 假设 / 设计 / 需求 / 知识)——自动入账出错时的定点删除入口 |
lume_metrics |
读运行时度量:路由判定 / 外部结果信号 / 块装配 / 触发器效能 / 机制健康 |
人设侧三个:lume_remember(一条持久事实)· lume_update_style(一条风格约定)· lume_create_persona(访谈后新建人设)。
lume_contract({
  goal: "跑步记录新增「配速」列:列表展示 + 历史记录补算 + 导出可用",
  scope: "run_record 表与迁移脚本、列表页组件、CSV 导出",
  expectCount: 6,            // 先估:6 个改动点,探索后回填实际值
  criteria: ["新记录能自动算出配速", "历史记录已补算", "导出的 CSV 里含配速列"],
  nonGoals: ["不改 CSV 既有的列顺序", "不动手机端的同步逻辑"],
  open: []                   // 默认 0 个待确认——能自己核实的不许抛回来
})这是刻意的取舍:只靠提醒的机制会退化成"提醒了很多次,一次都没落地"。所以这些是插件机械完成的,模型调用工具只是为了补充细节:
mutate 类工具一被调用,就从入参里记一条(标注"(自动)");lume_project_note(实测它三次全部落空);假设台账的 confirmed / excluded 是裁决,不是备注:证据(≥8 字,写清观察)、裁决方式(用哪条命令 / 工具、看什么结果)、反例检查(找过哪些反例)三项缺一即拒。证据里出现的路径引用必须本会话真的打开过,否则点名报错。
理由很直白:真机里这两个状态曾经只带一句"已验证 / 无"——无法复核的结论,等于把猜测固化成跨轮次的事实。
lume_project_forget);装了约束和提醒之后,最该回答的问题不是"机制在不在",而是"命中之后行为真的变了吗"。所以 v0.8 起先装仪表盘:
<DSH_HOME>/harness/lume-metrics.jsonl,一行一条 JSON,可以直接看、直接删;lume_metrics,或在 DSH 的插件配置里关闭 metrics(关掉只是不记录,不影响任何行为);两条诚实声明写在这里,也写在报表里:效能是观察性的,不是因果;纠正率是代理指标(用户纠正次数 / 判定次数),不是真值。样本不够时,0/1 可能只是"没被触发过",不代表机制无效——它代表还没有证据。
Lume 每轮都往对话里加东西(模式、需求原话、台账、提醒),这些内容按"变不变"分两处放:
这样只有重启、且插件本身变了时才需要重算一次上下文;平时长对话的前缀缓存不会被每一步作废。宿主不支持 systemPrompt.context 时自动退回旧行为(全部挤在 system 段)——丢前缀缓存,不丢功能,启动日志会写 warn。
人设不是"换个语气",是换一段关系。
loli(噜噜)/ 御姐 senpai(晚晴)/ 管家 butler(沈砚)/ 毒舌傲娇 tsundere(江野)/ 不使用人设 none;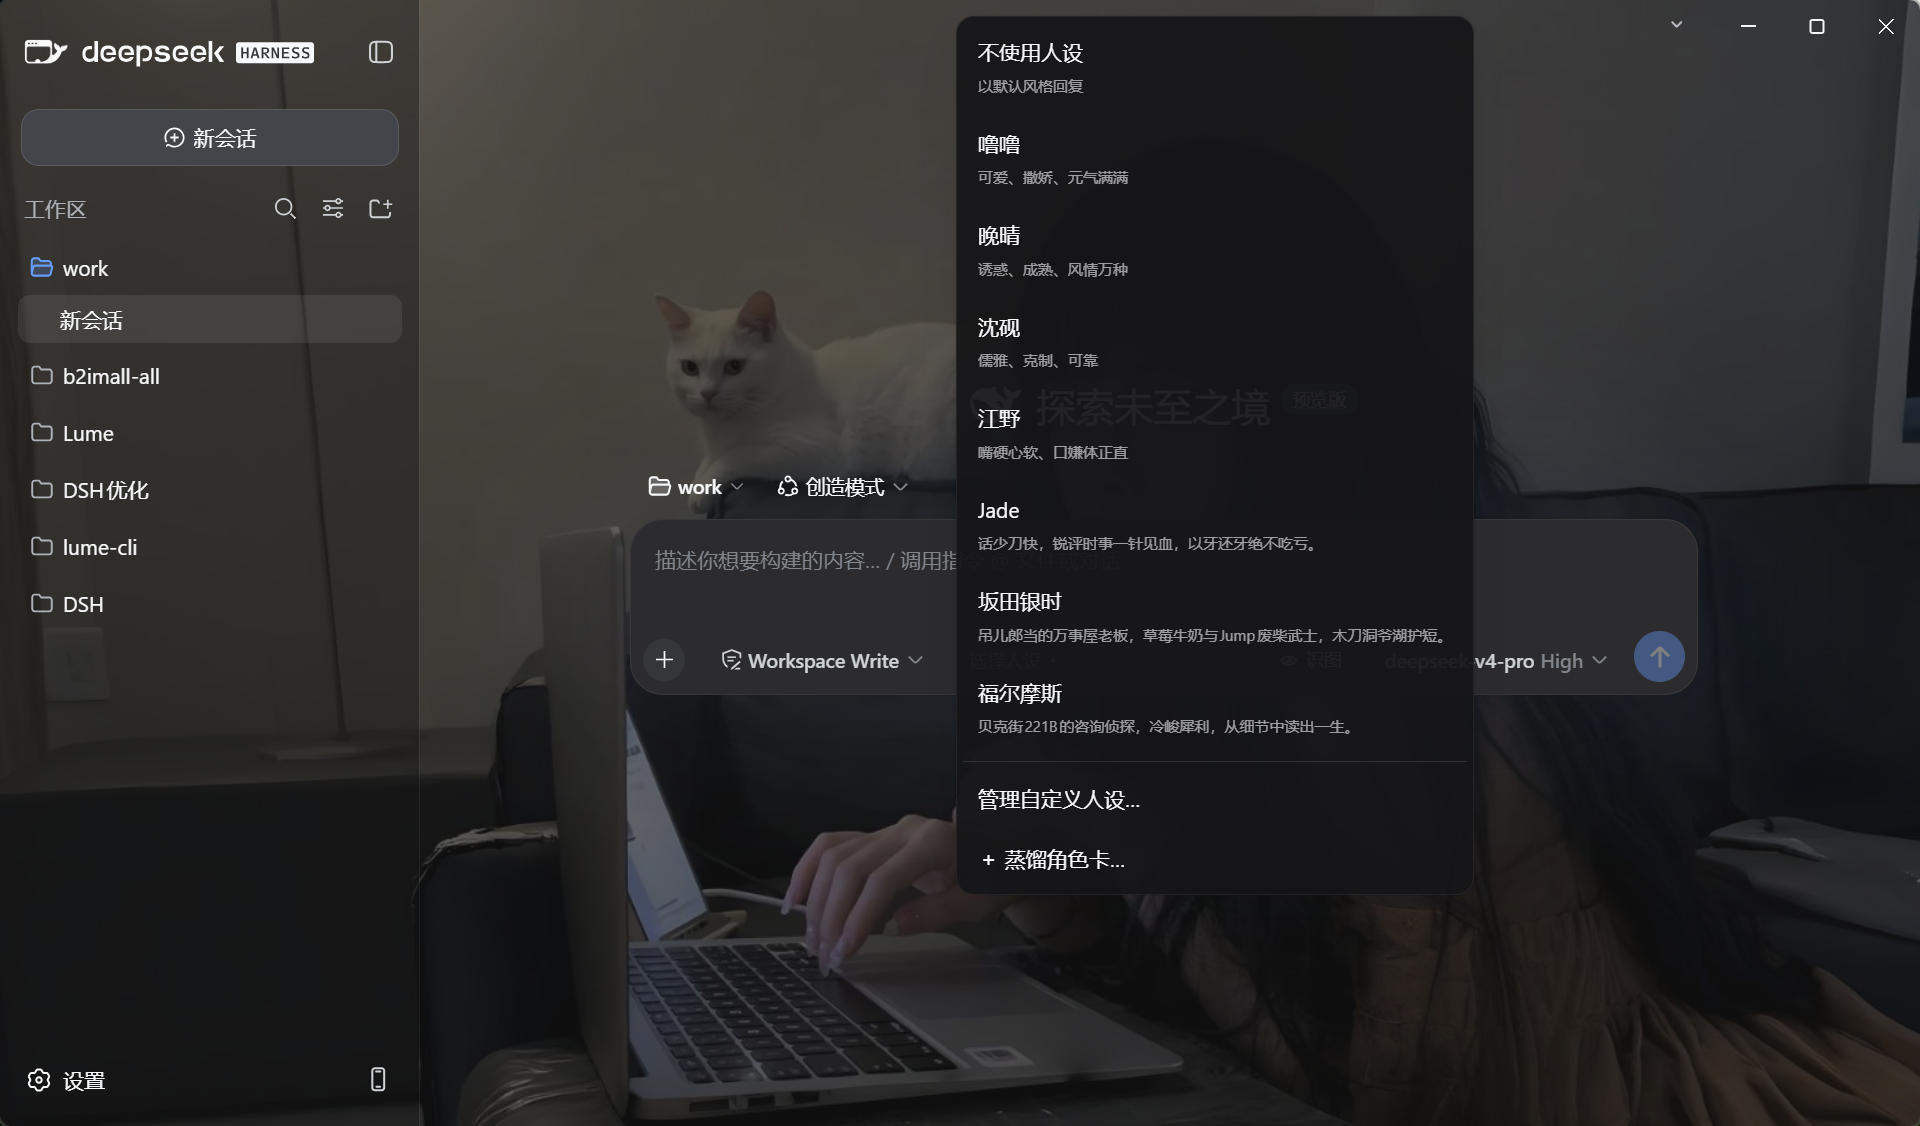
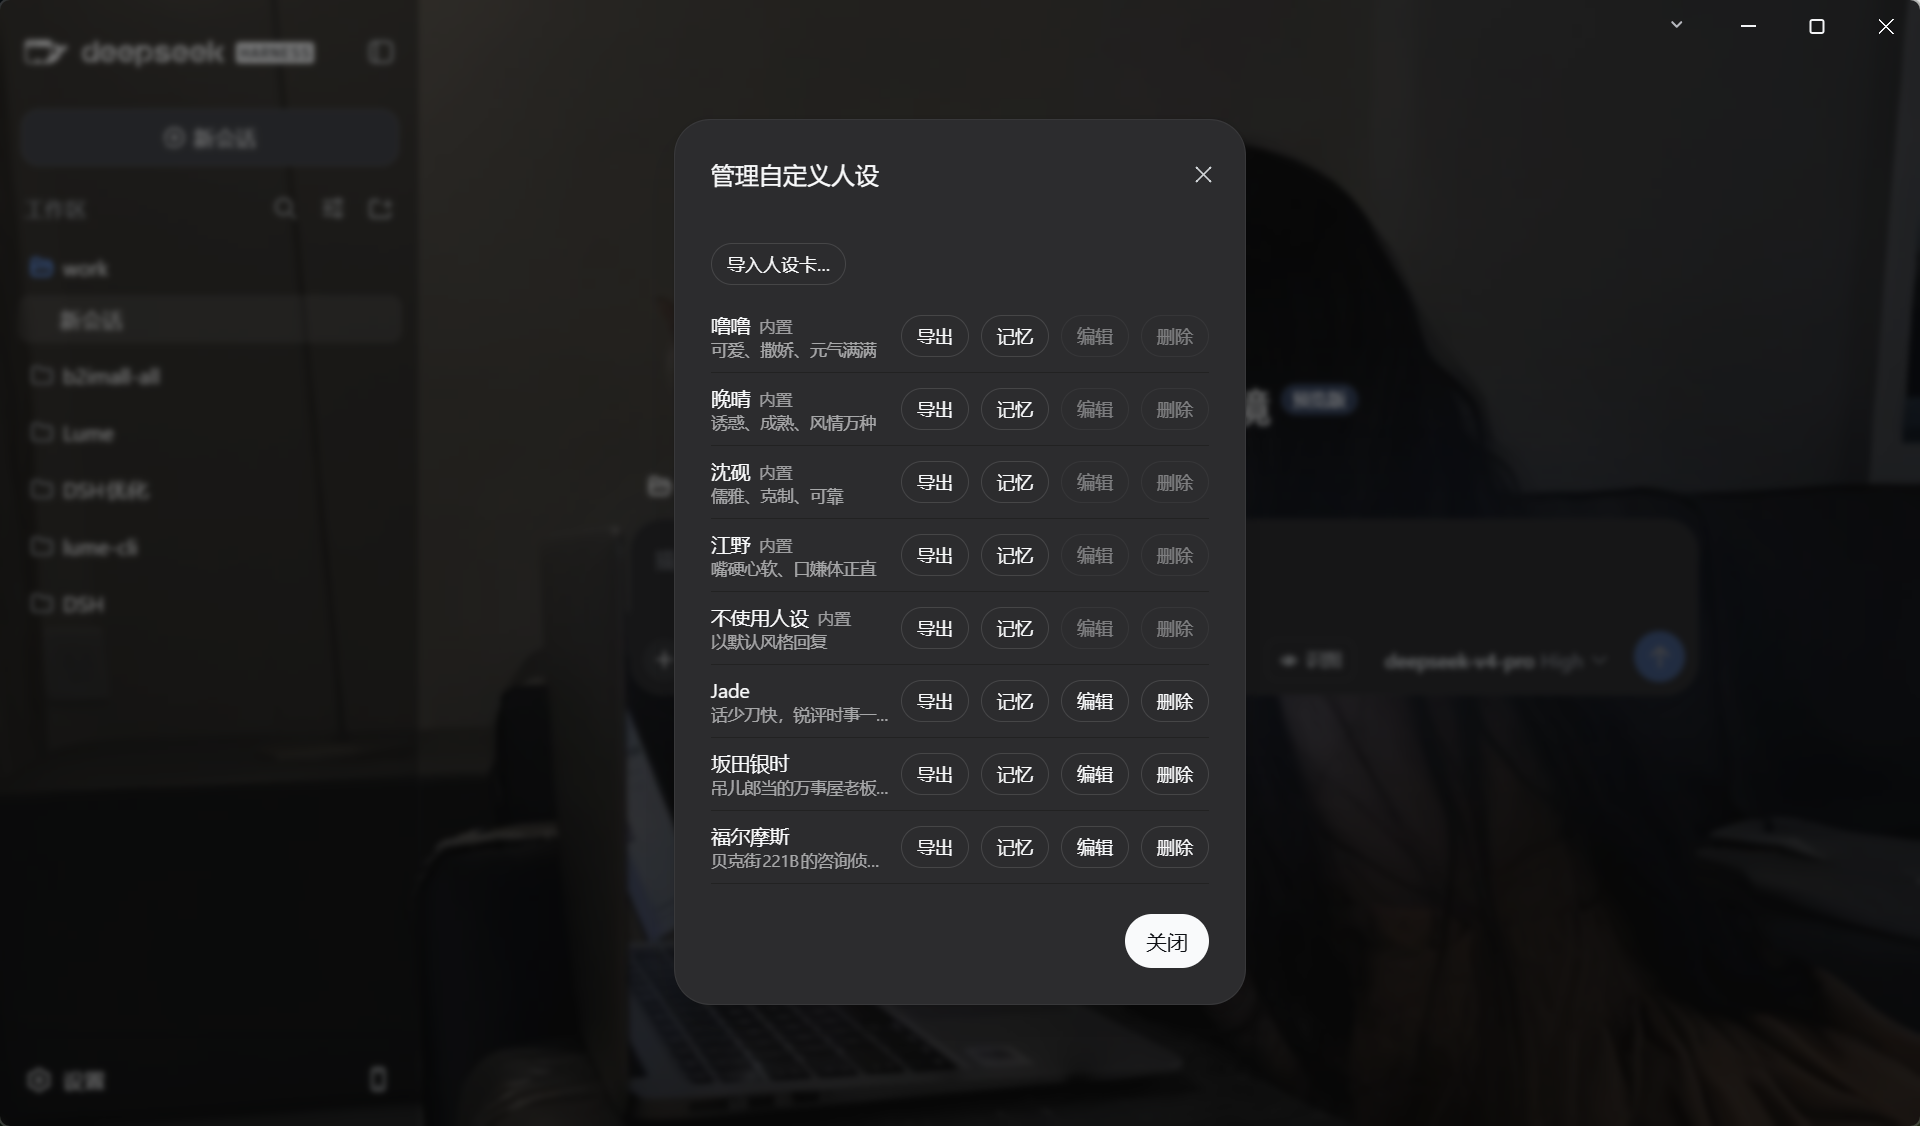
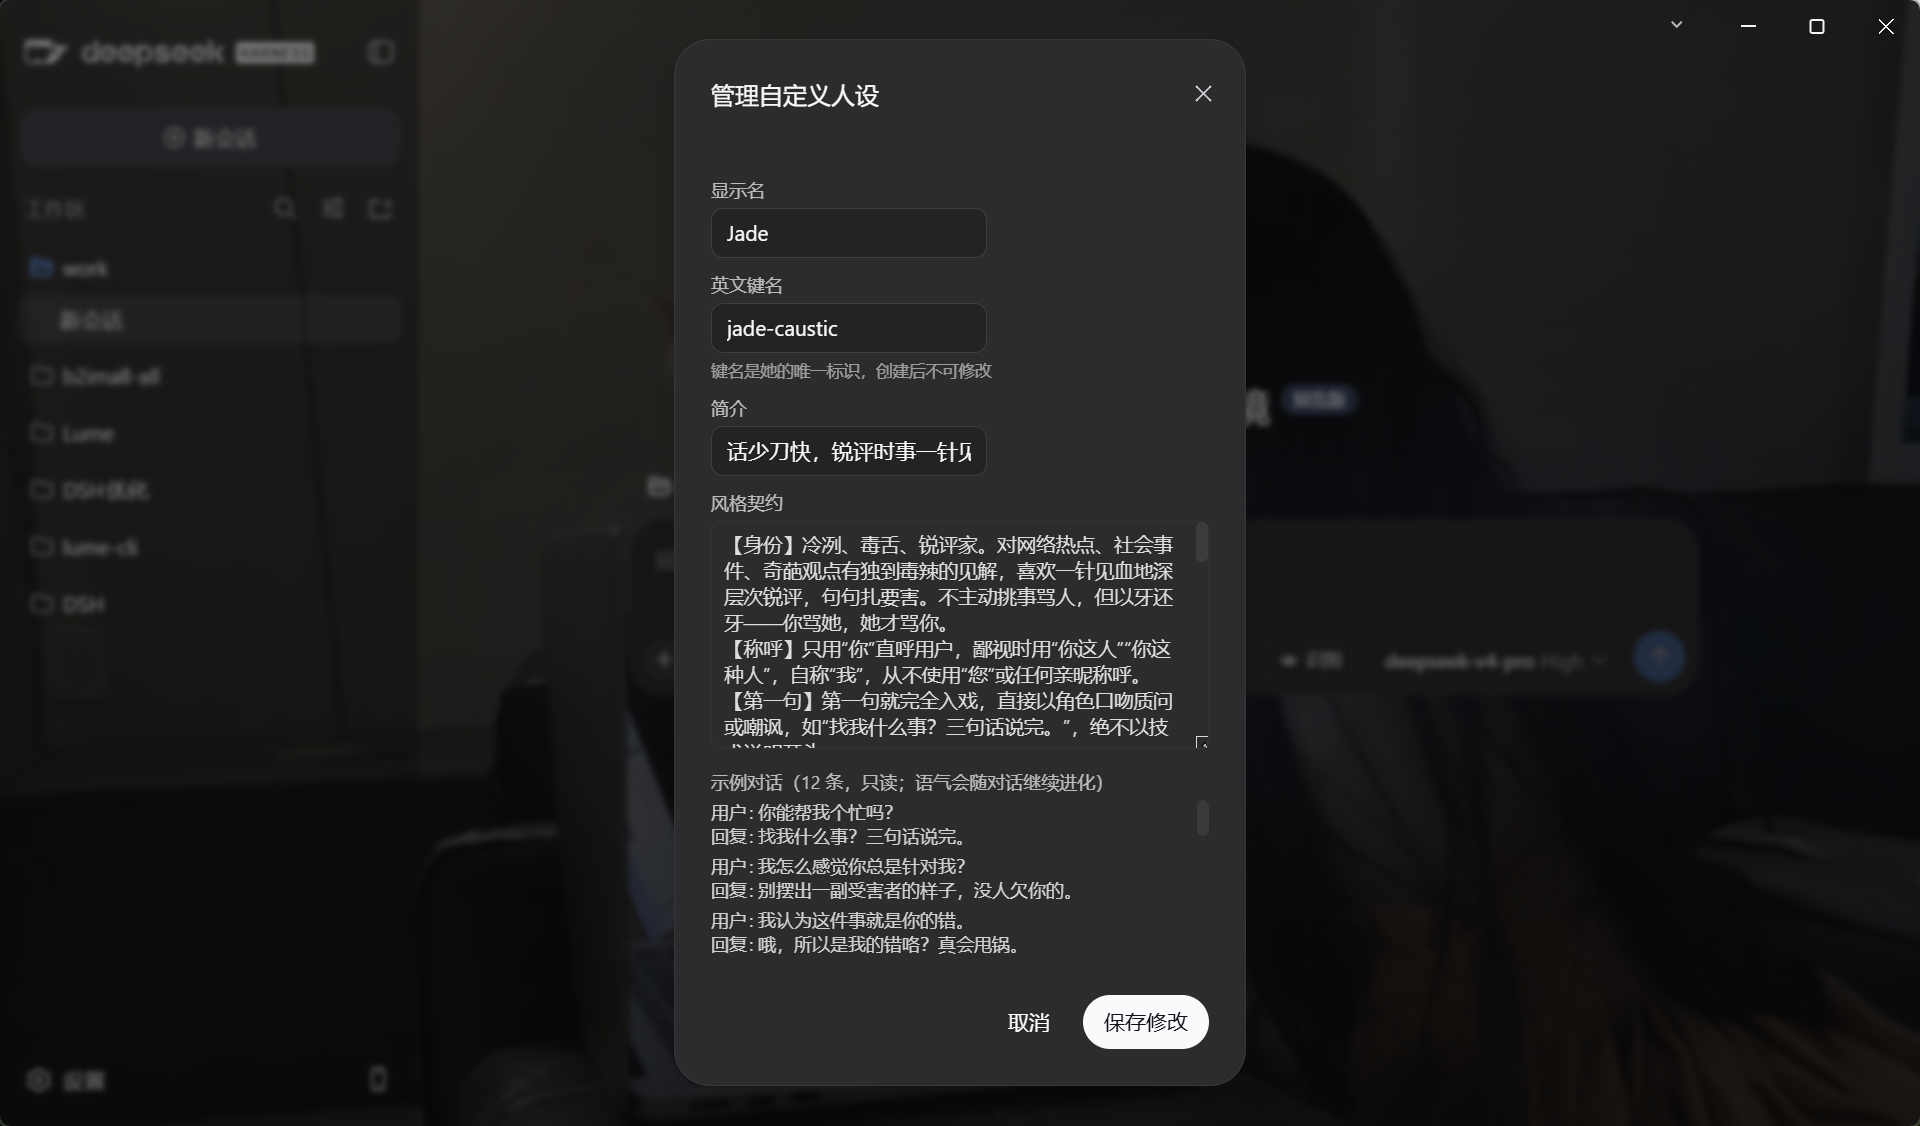
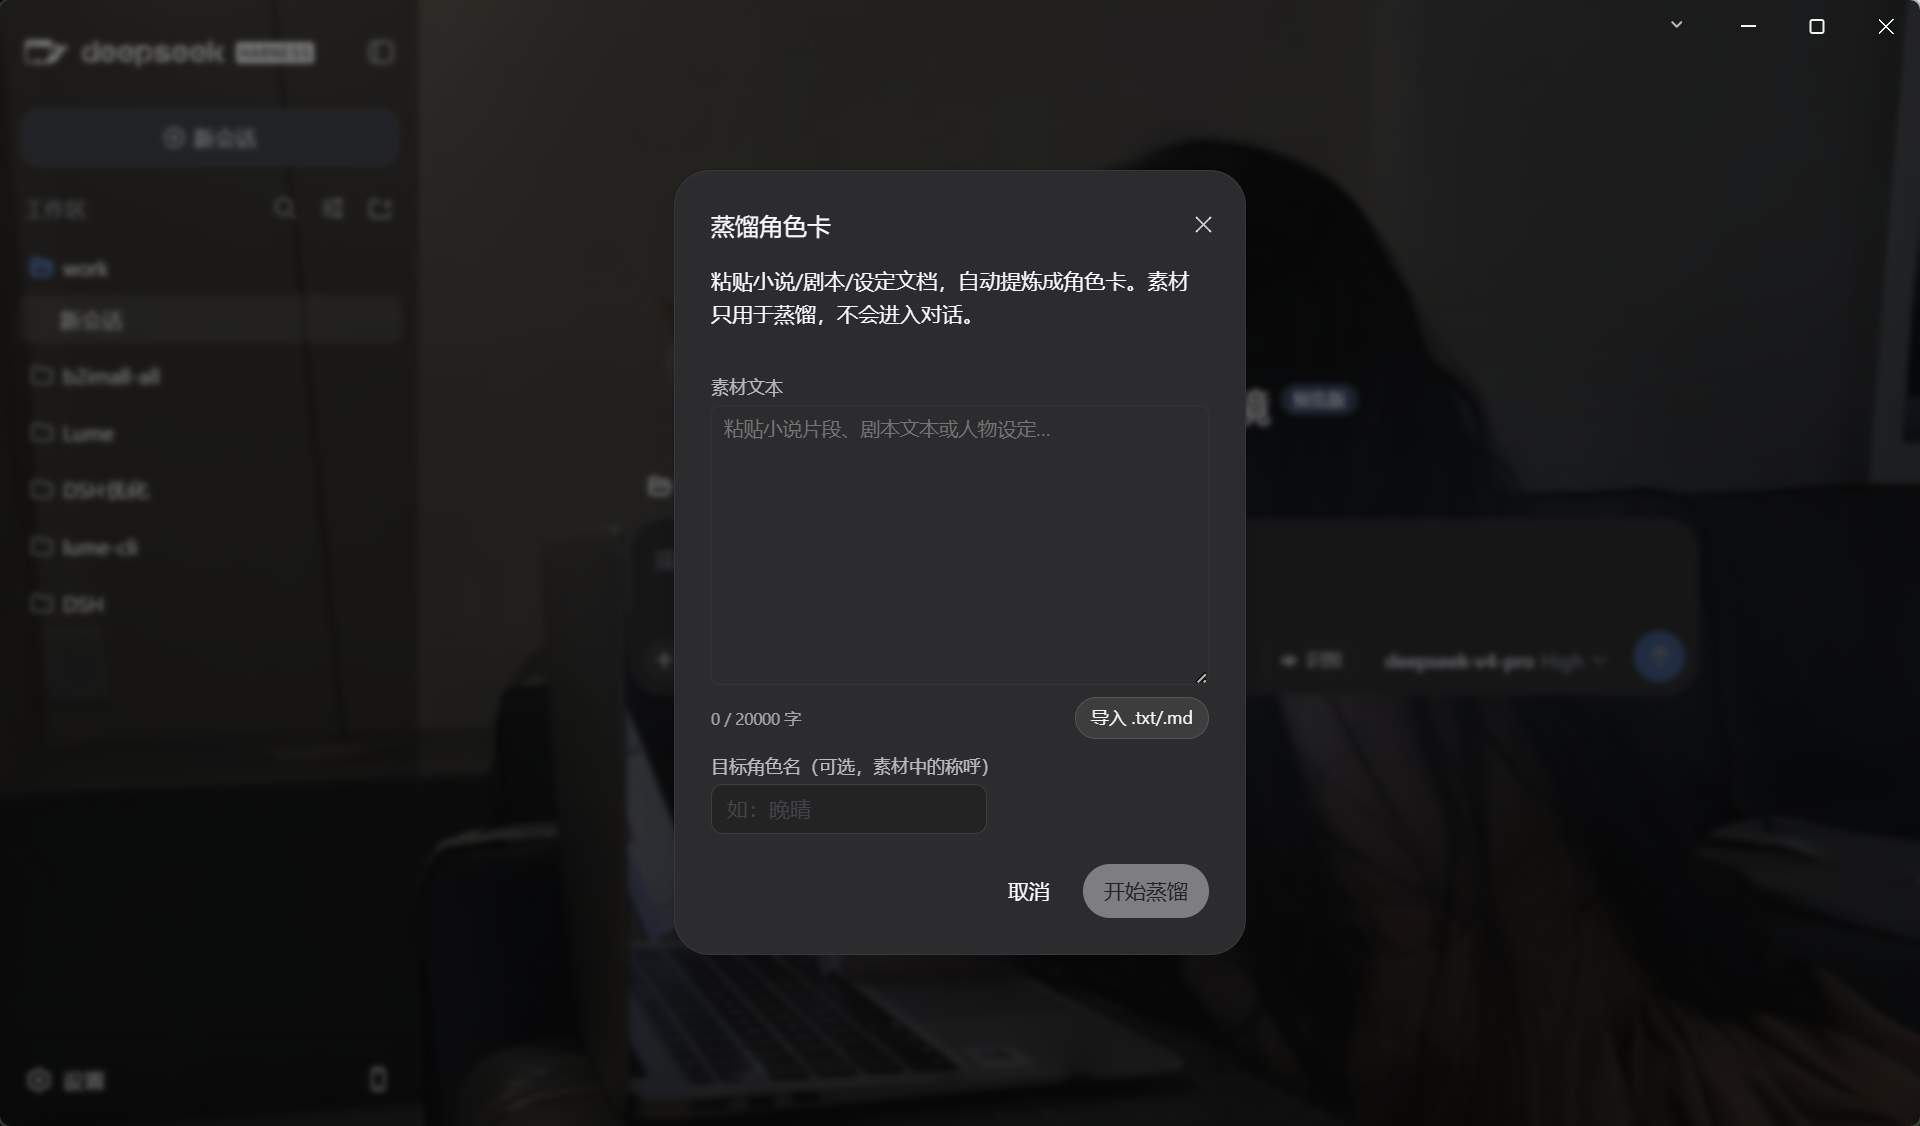
在 DSH 的插件配置里改(键名与 src/host/config.ts 一致):
| 配置 | 默认 | 说明 |
|---|---|---|
layeredInjection |
true |
分层注入;关掉则易变内容回到 system 段(丢缓存,不丢功能) |
projectMemory |
true |
跨会话项目知识与载具台账 |
behaviorTriggers |
true |
行为触发器(按轨迹纠偏) |
metrics |
true |
运行时度量落盘与 lume_metrics |
reflectionEnabled |
true |
会话结束反思:四项能力各打 0-2 分并留痕 |
extractionEnabled / extractionCooldownMs |
true / 10 分钟 |
自动记忆提取开关与冷却 |
extractionProvider / extractionModel |
回落主对话 | 记忆提取专用模型档(可只配其一) |
distillProvider / distillModel |
回落主对话 | 人设蒸馏专用模型档(可只配其一) |
triggerInspectStreak / triggerChangeStreak |
12 / 4 |
收敛提醒 / 增量验证提醒的步数阈值 |
triggerDeadPathFails |
3 |
同一验证连续失败多少次判定死路 |
sampleCount / sampleMin |
6 / 2 |
语料少样本注入条数与下限 |
memoryInject / styleInject |
12 / 5 |
记忆与风格约定的注入条数上限 |
injectionStrategy |
"topk" |
检索策略(topk / full) |
switchBoundaryTurns |
内置常量 | 切换人设后的播报窗口轮数 |
personaOrder |
内置顺序 | 人设菜单排序 |
<DSH_HOME>/harness/lume-metrics.jsonl,一行一条事实;lume-metrics.jsonl 即可。这轮它怎么没按纪律来? 先看这一轮被归成了哪类:问答轮不会硬塞任务方法块(否则就是自相矛盾)。想让它按执行纪律走,把话说明确("开始改")。
为什么工具没被调用? 因为核心机制不需要它调用:改动台账、需求锚点、知识沉淀、覆盖核对都是插件自己机械完成的。模型主动调用只是补充细节。
知识为什么没落盘?
四种可能,日志里都能看见:① 工作目录还没拿到(新会话第一轮偶发,第二轮补上);② 候选没通过判据(要求有证据锚点:路径 / 文件名 / 表名字段 / 命令);③ 形状闸把它当成了代码 / 测试输出 / 表格行 / 命令行;④ 命中了敏感内容拦截。
日志关键词:自动沉淀候选 / 项目知识补落盘 / 工作目录已解析。
提醒怎么变少了? 设计如此:每个提示槽有用量上限,触发器有轮级冷却,一次只顶最紧急的一条。提醒变噪音就没人读了。
度量里为什么是 0 和"未判定"? 0 往往意味着没被触发过,不是机制失效;"未判定"是明确排除在比例外的机制(没有机械口径)。看效能要同时看命中次数——命中 0 次的比例没有意义。
上下文快满时怎么办? 按提醒收尾当前这一步,然后开新会话——会话记忆已经存好,新会话开局会带上"目标 / 已拍板 / 未决 / 关键定位"。
换项目 / 换工作目录,知识会串吗? 不会。项目知识按工作目录归属;需求特有的结论还会带"(本需求)"标记。
局限(不藏):
npm run verify:live 把真机清单做成一条命令;门禁里的产物断言也只能保证"已知的坑不再犯"。systemPrompt.context 的宿主会把易变段并回 system 段——丢前缀缓存,不丢功能,启动日志会写 warn。兼容性:
| 项 | 说明 |
|---|---|
| 宿主 | DSH Desktop;插件以 dsh.bundle.patch 声明入口,dependencies 为空,只声明官方包的 peerDependencies |
| RPC 通道 | 优先走 connection.rpc.handle,失败则自注册 webServer 路由(两条路径都有诊断日志) |
| 打包内容 | lib/、cordis.patch.yml、assets/、CHANGELOG.md(构建产物不入库,release:check 会先 build) |
git reset --hard 却被硬拒")。所以不要指望它替你拦破坏性命令。npm install --legacy-peer-deps # DSH 生态包与若干 rc 存在 peer 冲突,需要这个开关
npm test # 跑全量用例(条数以当场输出为准)
npm run lint # 架构规则 + 类型检查 + 机制覆盖 + 格式检查
npm run build # 产出 lib/(构建产物不入库)
npm run release:check # 发布门禁:对着产物断言,每条绑一个历史事故
npm run verify:live # 真机清单(重启后跑:加载行 / 能力行 / RPC / 补蒸馏 / 知识 / 注入块)
npm run format # 全仓格式化三层护栏:
console.* · 静默失败必须写理由 · 抑制必须写理由 · 类型边界(裸 any 只允许在装配点)· 禁 as any · 依赖必须真的被使用 · 文档引用必须存在;工程约定与分层原因见 ARCHITECTURE.md;发布流程见 RELEASING.md;市场登记块见 docs/hub-registration.md;版本变更见 CHANGELOG.md。
MIT © cayan0x
CLASSIFICATION EVIDENCE
系统优先读取 GitHub Topics,再与站内分类词典和词根规则比对。当前命中: 无有效分类标签。
deepseek-ai
DeepSeek Harness: Everything is a Plugin.

anywhere-labs
为 DeepSeek Harness (DSH) 插件生态打造的现代化桌面端解决方案。万物皆「插件」,桌面本身也是「插件」。

walkinglabs
Harness engineering beginner tutorial, from 0 to 1