
其他
完整应用

deepseek-harness
deepseek-ai
DeepSeek Harness: Everything is a Plugin.
PROJECT TOPICS
PROJECT README
统一提取你电脑上所有 AI Agent Harness 的对话历史 → 归一为全量事件流(含工具链、思维链、Shell 执行、代码补丁)→ 本地 SQLite 存储可搜索 → 记忆蒸馏(LLM 离线提炼为结构化记忆)→ 内置记忆引擎 agentmemhub.rag(向量化 + 混合召回 + 价值评分,进程内直调、无独立服务)→ 面板双标签页浏览(统一会话 / 记忆报表)。
让任何 Agent 的会话经验,变成可检索、可迁移、可复用的统一记忆资产。
v2.0(2026-09-10):记忆后端从上游 MemOS 引擎切换为自研内置引擎
agentmemhub.rag——进程内直调,无独立服务、无端口、无守护进程,启动面板或跑sync即完整可用。 MCP 五工具与面板契约零改动;如需回退 MemOS,在agentmemhub.yaml设backend.backend: memos即可(vendoredmemOS/保留未删)。召回机制与实测数据见 docs/recall-fusion.md。v2.1(2026-09-11):新增记忆蒸馏(离线把会话提炼为结构化记忆,四入口: Python / CLI / start.bat 控制台 / 面板,详见「记忆蒸馏」章节);双标签页面板 (统一会话 / 记忆报表,含筛选·展开溯源·⭐加权·👍👎反馈·表头排序·双向跳转); 权重体系完整落地(来源初始分 → 反馈演化 → 手动加权不衰减)。
记忆索引依赖嵌入模型将文本向量化。仓库自带最轻量模型开箱即用,更大模型按需下载:
| 模型 | 维度 | 体积 | 说明 |
|---|---|---|---|
| bge-small-zh-v1.5 | 512 | ~23MB | 随仓库分发,clone 即可用(默认启用) |
| bge-base-zh-v1.5 | 768 | ~99MB | 精度更高(召回 0.930 vs 0.887),按需下载 |
下载更大模型(可选,二选一后改 agentmemhub.yaml 的 rag.active):
# 从 HuggingFace 镜像下载(默认走 hf-mirror)
uv run python scripts/fetch_model.py Xenova/bge-base-zh-v1.5

# 下载后在 agentmemhub.yaml 中把 rag.active 改为 bge-base-zh-v1.5
# (模型目录名即模型 id;下载脚本会自动登记到配置)
换 active 模型的标准流程(顺序错会出现"记忆搜不到"):
agentmemhub.yaml 的 rag.active(新模型须先登记进 rag.models);uv run python -m agentmemhub.rag.cli reembed --model <新模型>
(只补缺失用 uv run python -m agentmemhub rebuild --mode repair);嫌换模型麻烦?把 rag.write.order 配成多模型(如 small + base),
写入时每个模型各存一份向量,任意 active 都能召回。
模型来源:Xenova/bge-small-zh-v1.5 ·
Xenova/bge-base-zh-v1.5(均为量化 ONNX)。
网络受限时脚本自动回退代理;国内可加 --base https://hf-mirror.com。
| Agent | 数据来源 | 格式 |
|---|---|---|
| ZCode | ~/.zcode/cli/db/db.sqlite |
SQLite |
| OpenCode | ~/.local/share/opencode/opencode.db |
SQLite |
| Hermes | %LOCALAPPDATA%\hermes\state.db |
SQLite |
| WorkBuddy | ~/.workbuddy/workbuddy.db + audit-log |
SQLite + JSONL |
| Qwen | ~/.qwen/projects/*/chats/*.jsonl |
JSONL |
| QoderCN | ~/.qoder-cn/.../*.jsonl |
JSONL |
| DSH | ~/.dsh/sessions/*/session.jsonl.zstd |
zstd JSONL |
| Trae (CN) | %APPDATA%\Trae CN\ModularData\ai-agent\ + ~/.trae-cn/ |
Git 快照 + JSON + Markdown |
部分支持来源(最小可用):WorkBuddy 与 Trae 受源数据封闭限制,目前只能拿到 会话清单 + 局部数据(WorkBuddy:Shell 命令审计;Trae:每轮代码变更 diff + SOLO 产物清单 + 项目记忆),拿不到用户/助手的完整输入输出——等待官方开放接口后补全。
   ┌───────────────────────────── AgentMemHub(本项目) ─────────────────────────────┐
   │                                                                                 │
   │  采集层                        存储层                 消费层                     │
   │  ┌──────────────┐           ┌────────────┐     ┌────────────────────┐          │
   │  │ adapters/    │  ingest   │ SQLite 会话库│    │ CLI(7+ 子命令)      │          │
   │  │ 8 个数据源     │ ────────▶│ (store.py) │     │ 控制台(start.bat)    │          │
   │  │ (sqlite/jsonl)│           │ events+fts │     │ Web 看板(/api/*)    │          │
   │  └──────────────┘           └─────┬──────┘     └────────┬───────────┘          │
   │                                  │                      │                      │
   │   记忆层   ┌──────────────────────┼──────────────────────┘                      │
   │            ▼                      ▼                                             │
   │      统一事件流        向量化 ingest(按长度分桶 + 多模型编排)                      │
   │            │                      │                                             │
   │            │                      ▼                                             │
   │            │             ┌──────────────────────────────────┐                   │
   │            │             │ 内置记忆引擎 agentmemhub/rag      │                   │
   │            └────────────▶│ units + vec_<model> + trigram FTS │                   │
   │          (检索/看板/导出)│ 三路召回 RRF 融合 + 价值评分       │                   │
   │                          └──────────────────────────────────┘                   │
   │                                                                                 │
   │   配置层:agentmemhub.yaml(全路径可配置)+ 环境变量覆盖                           │
   └─────────────────────────────────────────────────────────────────────────────────┘
目录结构
AgentMemHub/
├── agentmemhub/                  # 核心包
│   ├── cli.py / console.py       # 命令行入口 / 交互式控制台
│   ├── config.py                 # 统一配置体系(YAML + 环境变量 + 默认)
│   ├── store.py + schema.sql     # SQLite 会话库(conversations/events/events_fts)
│   ├── watermarks.py             # 增量同步水位/变更集(delta)状态
│   ├── rag/                      # ★ 内置记忆引擎(v2.0)
│   │                             #   config/embedder/ingest/search/memstore/runtime
│   ├── rag_bridge.py             # ★ 引擎接缝:MCP/面板/cli 的统一调用入口
│   ├── health.py                 # 记忆库一致性巡检(面板健康卡片/CLI/测试共用判据)
│   ├── mcp_server.py             # MCP 记忆网关(stdio / Streamable HTTP;含调用审计)
│   ├── scoring.py                # LLM 三轴评分(策略层,与引擎的存值层分工)
│   ├── adapters/                 # 8 个 Agent 数据源适配器(src_id/turn_key/注入识别)
│   ├── web/                      # FastAPI 记忆面板 + 前端 + /api/memos 网关
│   └── memos.py / memos_daemon.py # 回退路径(backend=memos 时启用,默认不参与)
├── models/                       # 嵌入模型(自带 bge-small 开箱即用)
├── agentmemhub.yaml(.example)    # 统一配置(模型/分桶/召回/后端开关;本体 gitignore)
├── database/                     # 数据目录(gitignore):采集库 + 索引库 + 水位 + 评分状态
├── scripts/                      # 工具脚本(仅列常用)
│   ├── fetch_model.py            #   下载更大嵌入模型并登记到配置
│   ├── check_eval_grounding.py   #   召回评测集落地校验
│   ├── sensitive_scan.py         #   推送前敏感信息扫描
│   ├── web_verify.py             #   面板前后端接口联调自检(对运行中的服务)
│   ├── health_check.py           #   记忆库一致性巡检(与面板「记忆库健康」同判据)
│   ├── mcp_log.py                #   MCP 调用审计查询(logs/mcp.log 的读取端)
│   └── e2e/                      #   浏览器级端到端测试
├── eval/                         # 召回评测示例集(queries.example.yaml;私有集不入库)
├── tests/                        # pytest(488 项通过 / 1 项条件跳过)
├── docs/                         # 设计文档(架构/迁移/召回融合/接口契约等)
├── memOS/                        # 回退用的上游引擎(gitignore,默认不参与运行)
├── start.bat                     # 启动控制台(Windows)
├── ClearData.bat / ClearTest.bat # 清空数据 / 恢复干净测试环境
└── AGENTS.md / ARCHITECTURE.md # 协作约定 / 架构说明接口文档:对外接口(HTTP API / MCP 工具 / CLI)的完整契约见
docs/API.md;服务运行时还有交互式文档 /api/docs(Swagger UI)
与机器可读的 /openapi.json。
数据流(三阶段闭环)
ingest 从各 Agent 的官方数据位置读取会话(路径可经 agents.* 配置覆盖),归一为全量事件流(含工具链/思维链/Shell/补丁,每事件带 src_id/turn_key 稳定锚与系统注入标记)写入本地 SQLitesync 把事件流向量化写入内置索引(按长度分桶批处理、多模型并发、src_id 幂等)→ 对话时经三路召回(向量/全文/标识符)融合命中方式 A — 控制台(推荐,新用户入口)
# Windows 双击 start.bat,或命令行无参数直接进入菜单:
uv run python -m agentmemhub
菜单涵盖:提取入库 → 清洗数据 → 蒸馏记忆 → 写入记忆(向量化)→ 检索 → 看板启停 → 状态总览。 (自动评分入口已隐藏,见下方「命令行」表格备注)
方式 B — 命令行
# 1. 提取所有 Agent 并入库
uv run python -m agentmemhub ingest

# 2. 搜索(FTS5 英文 + 中文子串)
uv run python -m agentmemhub search "登录"

# 3. 查看某个会话(Markdown,含思维链+工具)
uv run python -m agentmemhub show zcode sess_xxxx

# 4. 导出全量(JSONL 每行一事件 / Markdown 可读)
uv run python -m agentmemhub export --format jsonl --out exports/
uv run python -m agentmemhub export --format markdown --out exports_md/

# 5. 写入记忆:采集 + 向量化(小模型先跑完即可检索,大模型后台并发补齐)
uv run python -m agentmemhub sync

# 6. LLM 批量评分(⚠️ 当前不生效:实测多为 neutral/全跳过;命令保留备查)
uv run python -m agentmemhub score# ---- 关键词搜索 ----
# 中文自动走 LIKE 子串匹配,英文/词组走 FTS5 全文索引
python -m agentmemhub search "登录" # 全部 8 个来源
python -m agentmemhub search "登录" --source zcode # 只搜某个来源
python -m agentmemhub search "登录" --role tool # 只搜工具事件
python -m agentmemhub search "登录" --role reasoning # 只搜思维链
python -m agentmemhub search "登录" --limit 50 # 条数限制(默认 20)
# ---- 查看单个会话(Markdown,含思维链/工具/补丁渲染)----
python -m agentmemhub show zcode sess_d8648672-3cc8-4bbc-8e4f-3e50afc6b032
python -m agentmemhub show opencode ses_0b10aad95ffe70V5
# ---- 列出会话 ----
python -m agentmemhub list # 全部来源
python -m agentmemhub list --source hermes # 只列某个来源# 导出为 JSONL:每个会话一个 <source>__<session_id>.jsonl,每行一个事件
python -m agentmemhub export --format jsonl --out exports/
# → exports/zcode__sess_d86486....jsonl, exports/opencode__ses_0b10....jsonl, ...
# 导出为 Markdown:人类可读,含 👤用户/💭思考/🔧工具/📝修改 渲染
python -m agentmemhub export --format markdown --out exports_md/
# → exports_md/zcode__sess_d86486....md, ...
# 只导出某个来源、指定输出目录
python -m agentmemhub export --format markdown --source zcode --out exports_zcode/
# 写入记忆索引(采集 + 向量化;小模型先跑完即可检索)
python -m agentmemhub sync导出的 JSONL 每行就是一个标准事件:
{"role":"user","content":"帮我修复登录页面","time":1750000001}
{"role":"reasoning","content":"登录按钮没反应,先看代码","time":1750000002}
{"role":"tool","tool_name":"Bash","tool_input":{"command":"npm test"},"tool_output":"FAIL src/login.ts","tool_status":"completed","time":1750000003}| 内容 | 默认位置 | 覆盖方式 |
|---|---|---|
| 数据目录(所有本地状态) | 项目内 database/ |
环境变量 AGENTMEM_HUB_DATA_DIR 或 yaml data_dir |
| 采集库(统一事件流) | database/agentmemhub.db |
环境变量 AGENTMEMHUB_DB |
| 记忆索引库(向量 + 全文 + 评分) | database/session_rag.db |
随数据目录 |
| 增量水位 / 评分记账 | database/watermarks.json · scored_traces.json |
随数据目录 |
| 嵌入模型 | models/ |
自带 bge-small;scripts/fetch_model.py 下载更多 |
| 导出目录 | exports/ |
--out 参数 |
默认数据已收进项目内
database/(已 gitignore,随项目走,备份/整机迁移只需带走项目目录)。 从旧版~/.agentmemhub迁移:把旧目录内容整体复制到database/即可 (agentmemhub.db连同-wal/-shm、scored_traces.json、config.json); 不迁移则视为全新环境,由增量 ingest 从各 Agent 源自动重建。
数据库三张核心表:
conversations — 会话元数据(source / id / title / cwd / model / 时间)events — 全量事件流(role / content / tool / reasoning / patch / shell,含 raw_json 原始保底)events_fts — FTS5 全文索引(英文检索)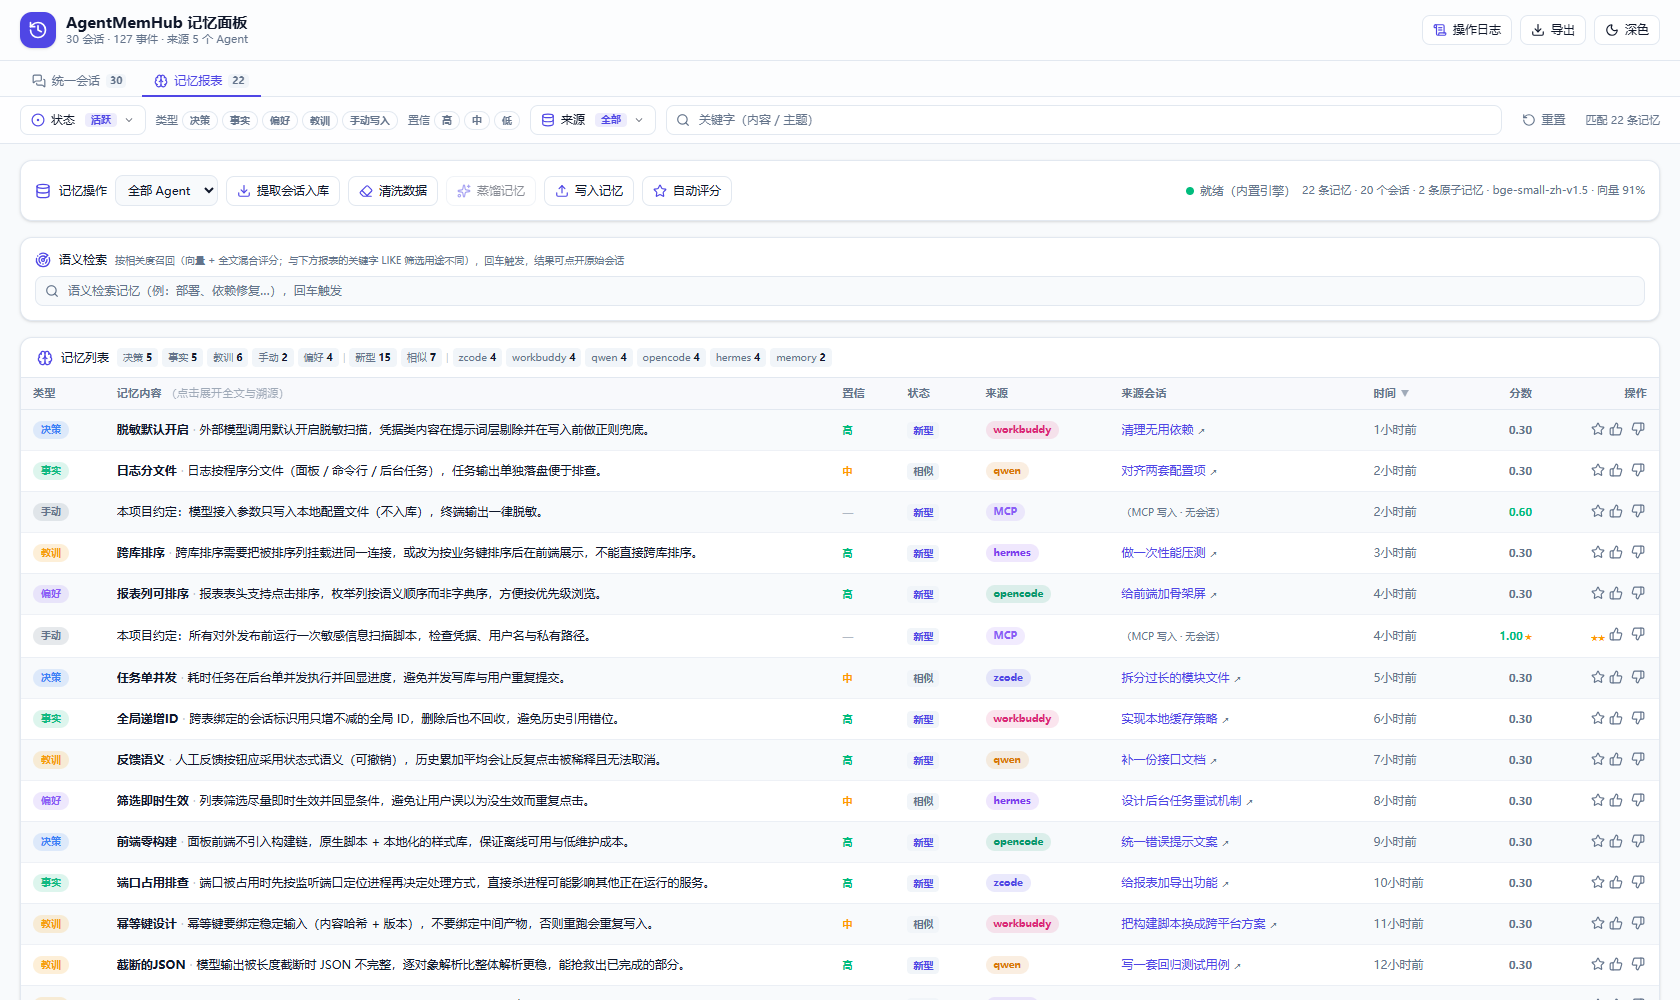
记忆索引库(database/session_rag.db,由内置引擎管理):
units — 记忆单元(消息级文本,模型无关;含 turn_key 轮次锚、legacy_id 旧系统别名与 tags 标签)vec_<model> — 每模型独立的向量表(sqlite-vec,维度建表时固定)units_fts — trigram 全文索引(中文友好,与标题列联合)unit_values / unit_feedback — 价值评分与反馈明细(引擎存值,打分策略在 Hub 侧)memory_exclusions — 位于采集库:记录哪些会话/轮次不写入记忆
exports/已加入.gitignore,含真实对话的导出不会进入仓库。
核心存储层可直接编程调用:
from agentmemhub.store import Store

store = Store()                                  # 默认 <项目根>/database/agentmemhub.db
convs = store.list_conversations("zcode")        # 列出 zcode 的会话
events = store.get_events("zcode", "<session-id>")  # 读取某会话事件流
hits = store.search("登录", role="tool") # 搜索工具事件不丢弃工具链、思维链、Shell 执行、代码补丁——每行一个 JSON 事件:
{"role":"user","content":"帮我修复登录页面","time":1750000001}
{"role":"reasoning","content":"登录按钮没反应,先看代码","time":1750000002}
{"role":"tool","tool_name":"Bash","tool_input":{"command":"npm test"},"tool_output":"FAIL src/login.ts","tool_status":"completed","time":1750000003}
{"role":"assistant","content":"是事件监听器问题","model":"claude-x","time":1750000004}
{"role":"patch","patch_file":"src/login.ts","patch_diff":"@@ -12,3 +12,5 @@","time":1750000005}
每个事件保留 raw_json(各 Agent 原始 JSON)实现无损保底。
| 命令 | 说明 |
|---|---|
ingest [--source x] [--full] |
提取全部/指定 adapter 并入库(默认会话级增量:只重读变化会话,见下文「增量同步架构」;--full 整源清空重建) |
list [--source x] |
列出会话 |
show <source> <id> |
查看会话(Markdown) |
search <q> [--source] [--role] [--limit] |
全文搜索事件正文 |
export --format jsonl\|markdown [--source] [--out dir] |
导出 |
folders [--source] [--limit] |
按文件夹统计各 Agent 会话数 |
sync [--source] [--full] |
采集 + 向量化写入记忆索引(增量;小模型先跑完即可检索,大模型后台并发补齐) |
mcp [--http] [--bind H] [--port P] |
MCP 记忆网关:默认 stdio(Agent 拉起);--http 常驻为 Streamable HTTP 供团队共享 |
rebuild [--mode repair\|rebuild] |
补齐缺失向量(repair)/ 全量重算 |
memos [--source] [--out] |
回退路径:生成 MemOS bundle(backend=memos 时用) |
clean [--source x] [--apply] |
记忆清洗:删除系统注入事件(默认预览,--apply 才执行并重建 FTS/计数;sync 会自动只清变更会话) |
score [--pending] [--limit N] [--dry-run] [--workers N] [--ids id1,id2] [--unscored-count] [--sync-episodes] |
⚠️ 当前不生效(入口已从控制台/面板隐藏;实测评为 neutral 居多且跑批全跳过,质量把关由蒸馏置信度 + 面板 👍/👎 承担)——命令保留备查。原功能:LLM 批量自动评分历史记忆(增量优先:pending_score 队列非空只评队列·定点读零全量枚举,队列空则先筛未评 id 再读正文;--pending 仅评队列,--ids 只评指定条(写后即评),--unscored-count 统计未评条数(只读 id),--sync-episodes 回填 episode.r_task;三档 verdict 均记入跳过清单——positive/negative 写 value、neutral 不写值但仍标记「已评」避免下次重评(dry-run 一律不记录);网关内容审核拒评(如智谱 1301)自动归 neutral 并记账,不再每次卡该条报错;LLM 调用强制直连、不受系统代理影响,确需代理设 AGENTMEMHUB_LLM_PROXY) |
rebuild [--mode repair\|rebuild] |
补向量:触发引擎 embedding rebuild(导入记忆后修复语义检索) |
stats / adapters |
统计 / adapter 状态 |
更完整的代码与 SQL 示例(按 Agent 查询、按文件夹跨 Agent 统计、会话角色分布、直连数据库等)见 docs/EXAMPLES.md。
提取入库、清洗、推送、评分不再全量扫描——整条链路围绕一个变更集(delta)运转:
adapter.list_sessions(轻量清单) ──对比──▶ 库内 updated_at
        │ 只重读变化会话(load(only_ids))
        ▼
store.upsert_sessions(会话级 upsert,单事务,源端已删会话保留=历史保全)
        │ 变更集写入 <data_dir>/watermarks.json
        ▼
clean(只清变更会话的注入事件) → push(只构建/推送变更会话的 traces)
        │ 推送成功的 trace id 入 pending_score 队列
        ▼
score(增量优先:队列非空只评队列·定点读引擎库,队列空才全量筛未评——零无谓全表枚举)适配器三级增量策略(新 adapter 按数据源能力自选层级,见 adapters/base.py):
| 层级 | 机制 | 适用 |
|---|---|---|
| 会话级清单 | list_sessions() 只读 id/时间(单 SELECT / rglob+stat / 首行 peek),精确对比逐会话 |
zcode、opencode、hermes、workbuddy(表)、qwen、qodercn、dsh(peek 首行) |
| 源级新鲜度 | source_freshness() 最大 mtime > 上次水位 → 整源重扫(force upsert),兜底清单看不见的变更 |
workbuddy 审计日志追加 |
| 整源重扫 | 无轻量清单 → 整源 load,upsert 按 updated_at 幂等对比 | trae(快照 git 仓库,量小) |
watermarks.json(<data_dir>/,version 化,扩展点:新流水线阶段读 delta、登记自己的 consumed 时间戳即可接入):
last_ingest.sources — 每源上次同步水位(新鲜度信号对比基准)delta.conversations — 变更会话集 [{source, id, status}];连续两次 ingest 之间下游未消费时自动合并防丢;超 cap(5000) 标记 oversized,下游该轮回退全量扫描(正确性优先)pending_score — 待评分 trace id 队列(评分入口增量优先消费:面板/控制台/score/score --pending 队列非空即只定点评这批,成功后出队、有失败整队列保留下次重试)consumed — 各阶段消费水位;推送有失败批次时不标记,下次 sync 重试水位文件缺失/损坏 = 无状态,下一次 ingest 仍可运行(对比基准是库本身),下游回退全量——任何时候 ingest --full 都是逃生口。
可写数据(SQLite 库、watermarks、评分状态、托管 pid)默认落 <项目根>/database/
——随项目走,备份/整机迁移只需带走项目目录;database/ 已 gitignore,严禁入库。
环境变量 AGENTMEM_HUB_DATA_DIR 或 yaml data_dir 仍可覆盖(测试隔离/自定义位置,
测试套件由 conftest 强制指向临时目录)。
ClearData.bat Y 一键清空应用数据重新开始(不动引擎与 Agent 源数据);
旧版数据在 ~/.agentmemhub,整体复制进 database/ 即完成迁移。
记忆能力要真正用起来,需要三步配置。只配 MCP 不配另两项,记忆不会自动沉淀—— Agent 不会自觉保存,必须靠规则约束。
见下节「MCP 记忆网关 → 注册配置」。配好后 Agent 才能调用 memory_save / memory_search。
git clone https://github.com/MerlinShieh/Agent-skill-save-memory.git ~/.zcode/skills/save-memory # ZCode;其他 Harness 放对应 skills 目录Skill 定义何时保存(写入即完成,不自动评分——价值分由真实使用演化)。它不含存储实现, 强绑定本项目的 MCP 工具,无降级路径。
Skill 的触发依赖模型自觉,长对话/高负载下会漏触发。必须把下面这条硬规则
加入当前项目的 AGENTS.md 或 Harness 的全局指令文件
(如 ~/.zcode/AGENTS.md、~/.config/opencode/AGENTS.md、~/.qwen/QWEN.md):
## 记忆保存纪律(硬性规则)

长期记忆存在本地记忆索引(AgentMemHub 内置引擎 agentmemhub.rag),
通过 agentmemhub MCP 工具读写。任务收尾时自查:本次是否产出了可复用结论
(问题解决步骤 / 踩坑解法 / 架构决策 / 关键配置变更)?命中必须:

1. memory_stats 探活——不可用时告知用户建立索引
   (AgentMemHub 项目内 uv run python -m agentmemhub sync;内置引擎无守护进程,
   没有"启动引擎"这个动作),不硬写;
2. memory_save 写入自包含结论(背景一句话 + 结论/做法);
3. 写入后不自动评分——价值分由真实使用演化(面板 👍/👎,或按需 memory_score)。

⚠️ 只写 Agent 自己的本地会话记忆不算完成——必须落到记忆索引。
需要历史经验时主动 memory_search,与保存流程互相独立。
本项目仓库内已含
AGENTS.md(见根目录),可直接参考;跨项目使用时把上面这段 复制到你自己的项目或全局指令文件。为什么必须做这步:没有这条规则,Skill 只是"能力"而非"义务", 会在最需要它的时候被遗忘——这是实践中反复验证的结论。
把内置记忆引擎(agentmemhub.rag)的语义检索/写入包装成 MCP server,挂在 ZCode / OpenCode /
Claude Code 等支持 MCP 的 Agent harness 上——模型在会话进行中即可检索历史记忆、
主动保存值得长期保留的结论。与离线链路(统一提取 → bundle → 导入)互补。
⚠️ 本网关必须与 save-memory Skill
配套安装(触发纪律所在,见下文「必装组件」),只配 MCP 不装 Skill 不算接入完成。
| 工具 | 说明 |
|---|---|
memory_search(query, topK?, note?) |
语义检索历史记忆(三路混合召回),返回命中条目 + 注入上下文 |
memory_recent(limit) |
最近写入的记忆时间线,快速了解近期积累 |
memory_stats() |
索引就绪状态 / 记忆总量 / 嵌入模型与 LLM 评分可用性 |
memory_save(content, importance?, tags?, note?) |
写一条记忆。importance 为可选档位(high/normal/low → 初始价值 0.8/0.6/0.4,不传即 normal),由 Agent 用当前推理直接判断,无需外挂评分模型;tags 为可选标签数组(面板筛选/溯源用,引擎纯透传)。即时入库并补向量,写后验证 imported,失败明确报错不伪装 |
memory_score(trace_id, polarity, note?) |
按需对任意一条记忆打分(反馈 → 引擎即时重算 value/priority;写后即评流程已废除,仅用户明确要求加权时使用) |
表中
note?是这三个工具共有的可选参数:写一句话操作意图(例:note="排查用户说的召回异常")。 它只进审计日志logs/mcp.log,不参与检索与存储——调用本身由服务端自动记录,note补充的是"为什么"。 查询日志:python scripts/mcp_log.py [--tool X] [--failed] [--grep 词]。
# 0. 确保记忆索引已建立(v2.0 起引擎内置,无需启动任何服务):
uv run python -m agentmemhub sync

# 用法一:本地个人(stdio,Agent 拉起子进程)——见下方「注册配置」
# 用法二:团队共享(Streamable HTTP,一台机器常驻网关):
uv run python -m agentmemhub mcp --http --bind 0.0.0.0 --port 9100

# 验证:在 Agent 会话里调用 memory_stats / memory_search⚠️ 记得把下方
<项目根>替换为你机器上的实际路径(例如D:/path/to/AgentMemHub)。 不要用uv run python——MCP 子进程在项目目录之外启动时会解析到错误的 python(No module named agentmemhub)。 ZCode 写在mcp.json的mcpServers段;OpenCode 写在opencode.json的mcp段(模板另见 docs/mcp-register.example.json)。
A. 本地个人(stdio)
{
  "mcpServers": {
    "agentmemhub": {
      "type": "stdio",
      "command": "<项目根>/.venv/Scripts/python.exe",
      "args": ["-m", "agentmemhub", "mcp"],
      "env": {}
    }
  }
}
OpenCode 对应写法(含裸命令备选:pip install -e . 后把 .venv/Scripts 加入 PATH,command 直接用 agentmemhub-mcp):
{
  "mcp": {
    "agentmemhub": {
      "type": "stdio",
      "command": "<项目根>/.venv/Scripts/python.exe",
      "args": ["-m", "agentmemhub", "mcp"],
      "enabled": true
    }
  }
}
B. 团队共享(Streamable HTTP)
服务端先常驻:python -m agentmemhub mcp --http --bind 0.0.0.0 --port 9100(默认只监听 127.0.0.1,开放局域网需显式 --bind 0.0.0.0 并自行做好访问控制)。客户端注册:
{
  "mcpServers": {
    "agentmemhub": {
      "type": "http",
      "url": "http://<服务器IP或hostname>:9100/mcp"
    }
  }
}
两种传输的工具完全一致(
memory_search/memory_recent/memory_stats/memory_save/memory_score),按场景选一种即可。
MCP 网关只提供「做得到」(执行层工具),不解决「何时必须做」——Agent 主动保存记忆并 写后即评的触发纪律,由独立 Skill 仓库承载:
该 Skill 是本记忆链路的必装组件(不装则模型保存记忆行为不可靠:漏保存、保存不评分, 本项目实测踩过)。完整启用需要三件套,缺一不可:
# ZCode
git clone https://github.com/MerlinShieh/Agent-skill-save-memory ~/.zcode/skills/save-memory
# OpenCode(或 ~/.agents/skills/)
git clone https://github.com/MerlinShieh/Agent-skill-save-memory ~/.config/opencode/skills/save-memory
AGENTS.md 或 harness 全局指令文件(如 ~/.zcode/AGENTS.md)。三层边界:AGENTS.md 管「必须做」、SKILL.md 管「怎么做」、MCP 管「做得到」。 Skill 与 MCP 强绑定、无降级路径——MCP 不可用时 Skill 会明确提醒配置而非改用别的方式保存。
设计要点:
memos-daemon);网关只转发请求,引擎离线时所有工具
返回明确错误与启动指引(isError),不做启停决策POST /mcp 单端点(GET 405、DELETE 结束会话),
兼容 MCP 2024-11-05 / 2025-06-18采集库(database/agentmemhub.db):
session_uid 全局递增会话 ID 与 title_custom 用户改标题标记)索引库(database/session_rag.db):
role='distilled'、src_id='dst_<内容hash>')manual_value = 用户 ⭐ 锁定值)与反馈记录详见 ARCHITECTURE.md 与 docs/memory-distillation.md。
v2.0 起记忆引擎内置于本项目(agentmemhub/rag/),进程内直调:
无独立服务、无端口、无守护进程、无鉴权。启动面板或执行一次 sync 即完整可用。
AgentMemHub/
├── agentmemhub/
│   ├── rag/                     ← 内置记忆引擎(向量化 / 混合召回 / 价值评分)
│   ├── rag_bridge.py            ← 引擎接缝:以原 MemOS 端点语义实现进程内调用
│   └── memos*.py                ← 回退路径(backend=memos 时启用)
├── database/                    ← 采集库 agentmemhub.db + 索引库 session_rag.db
├── models/                      ← 嵌入模型(自带 bge-small;更大模型按需下载)
└── agentmemhub.yaml             ← 统一配置(模型/分桶/召回/后端开关)
常用操作:
uv run python -m agentmemhub sync        # 采集 + 向量化写入记忆索引(首次必跑)
uv run python -m agentmemhub score       # LLM 批量评分(⚠️ 当前不生效,见命令行表格备注)
uv run python -m agentmemhub stats       # 索引规模统计
uv run python -m agentmemhub serve       # 启动记忆面板 http://127.0.0.1:8086
要点:
sync;
面板/CLI/MCP 谁会用到谁就在自己进程里加载,不需要也不能"启停服务"。agentmemhub.yaml 的 rag.write.order 支持多模型。
默认策略是小模型先跑完即可检索(bge-small 约 3 分钟完成全量),
高精度模型在后台子进程并发补齐,完成后自动生效。agentmemhub.yaml 的 backend.backend: memos(或设环境变量
AGENTMEMHUB_BACKEND=memos)即可切回 vendored 引擎,此时才需要其独立服务与
memos-daemon 管理命令。离线把原始会话去噪提炼为结构化记忆(决策 decision / 事实 fact / 偏好 preference / 教训 lesson),是检索质量的来源。四个使用入口:
| 入口 | 方式 |
|---|---|
| Python | from agentmemhub.distill import run_distill; run_distill(settings) |
| CLI | uv run python -m agentmemhub distill [--source X] [--limit N] [--dry-run] |
| 控制台 | start.bat → [3] 蒸馏记忆 |
| 面板 | 「记忆报表」页 →「蒸馏记忆」按钮(后台任务 + 进度条,两页可见) |
流程(五阶段,全本地):
S0 切片      固定轮数窗口(默认 16 轮)+ 话题边界细化 —— 追加新对话时
             已满窗口的历史切片逐字不变(增量稳定,不反复重蒸)
S1 段级蒸馏  LLM 逐片提炼 → 结构化 JSON(脱敏;丢弃寒暄与过程叙述)
S2 合并沉淀  同会话多片再合并去重(层级合并,批次化防超上下文)
S3 跨会话去重 与既有记忆向量近邻 → 三档标记 new / similar / duplicate
S4 投影      新/相似条目写入 units(role='distilled')→ 立即可被召回
要点:
agentmemhub/sanitize.py)distilled_memories + 投影 units),
不影响采集库原文;排除(memory_exclusions)与删除会同步作用于投影LLM 接入(agentmemhub.yaml 的 llm 段;也可用 scripts/sync_llm_from_zcode.py
从 ZCode 客户端配置一键同步,密钥只写入 gitignore 的本地配置):
llm:
  endpoint: "https://api.deepseek.com/chat/completions"   # OpenAI 兼容端点
  api_key: ""                    # 只写入 agentmemhub.yaml(已 gitignore),不入库
  model: "deepseek-v4-flash"
  headers:                       # 可选:provider 特定请求头
User-Agent: "AgentMemHub/1.0"所有路径/端口默认采用官方默认;需要覆盖时创建 agentmemhub.yaml(模板见 agentmemhub.yaml.example)。优先级:环境变量 > 配置文件 > 内置默认。
data_dir: database                    # 本地状态根目录(采集库/索引/水位/评分)
db_path: ""                           # 采集库 SQLite(留空 = <data_dir>/agentmemhub.db)

backend:
  backend: rag                        # rag(内置引擎,默认)| memos(回退)

rag:
  active: bge-small-zh-v1.5           # 检索用模型(随仓库分发,开箱即用)
  write:
    # 多模型写入(真正生效):逐模型各存一份向量——换 active 后旧记忆不会
    # 因向量在另一张表而在召回侧隐形;代价是写入耗时随模型数增加
    order: [bge-small-zh-v1.5]        # 向量化顺序;可加更多模型
    fast_first: true                  # 首个模型完成即返回可检索,其余后台并发
    background_hint: "高精度模型正在后台向量化,稍后自动生效"
  embed:
    batch_size: 32
    bucketing: true                   # 按文本长度分桶批处理(性能关键)
    bucket_caps: [64, 128, 256, 384]  # 分桶边界(字符)
  retrieval:
    # 多模型召回融合(真正生效,2026-09-11 起):逐模型向量路 + RRF;
    # 同门模型重叠度高,扩展前先评测
    models: [bge-small-zh-v1.5]
    candidate_k: 30                   # 每路候选数
    threshold_floor: 0.2              # 相对阈值(×top)
    max_per_conversation: 2           # 同会话限席(原子记忆不受限)
    search_max_hits: 20               # 面板检索返回上限
  models:                             # 模型注册表(新增模型在此登记)
    bge-small-zh-v1.5:
      path: models/bge-small-zh-v1.5
      dim: 512
      pooling: cls
      quantized: true
      maxTokens: 512

agents:
  zcode: ""                           # 各 harness 会话位置;留空=官方默认自动发现
  hermes: ""
memos:                                # 仅 backend=memos 时参与
  base_url: "http://127.0.0.1:18800"
  repo_dir: ""

web:
  port: 8086

llm:                                  # 蒸馏与评分共用(OpenAI 兼容端点)
  endpoint: "https://api.deepseek.com/chat/completions"
  api_key: ""                         # 只写入本地 agentmemhub.yaml(gitignore)
  model: "deepseek-v4-flash"
  headers: {}                         # 可选:provider 特定请求头

distillation:                         # 记忆蒸馏全部可调(不硬编码)
  enabled: true
  prompt_ver: null                    # 留空=跟随代码内版本(改提示词自动重蒸)
  slice: {max_turns: 16, max_chars: 24000, topic_boundary: true}
  merge: {enabled: true, max_chars: 8000, max_rounds: 6}
  dedup: {cosine_duplicate: 0.92, cosine_similar: 0.80}
  sanitize: {enabled: true}
  runtime: {max_concurrent: 4, timeout: 60}
# llm: {} # 可选:蒸馏单独覆盖顶层 llm(继承+合并)相对路径相对项目根解析,~ 展开为用户目录。
uv sync 即可装齐依赖)onnxruntime(嵌入推理)、tokenizers、numpy、sqlite-vec(向量检索)、
pyyaml(配置)、zstandard(DSH 数据源解压)fastapi、uvicorn(uv sync --extra web)不想敲命令行?启动本地 Web 仪表盘,在浏览器里浏览/搜索/管理所有 Agent 会话:
# 首次:安装 web 可选依赖(fastapi + uvicorn)
uv pip install -e ".[web]"

# 启动(默认 http://127.0.0.1:8086,--open 自动打开浏览器)
uv run python -m agentmemhub serve
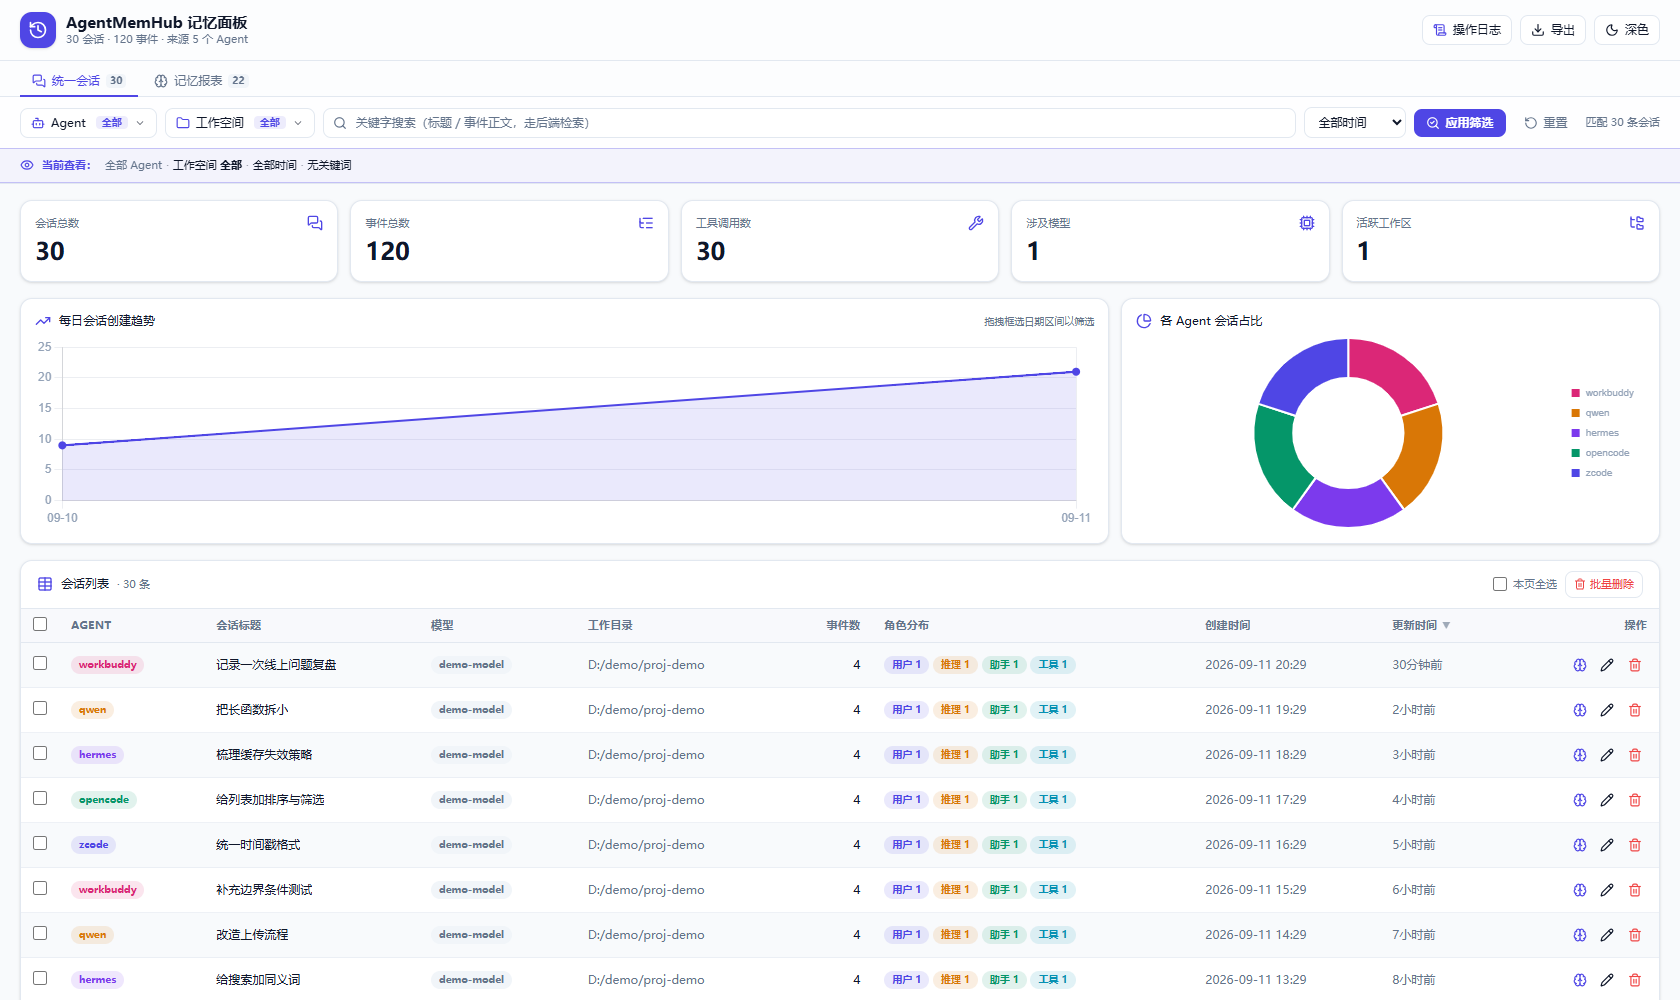
uv run python -m agentmemhub serve --port 9000 --no-open --db D:/path/to/agentmemhub.db功能:双标签页——「统一会话」与「记忆报表」分开呈现,互不混排。
统一会话页:Agent/工作空间多选筛选 · 服务端分页列表 · 全文搜索(FTS5+LIKE)· 统计卡与图表 ·
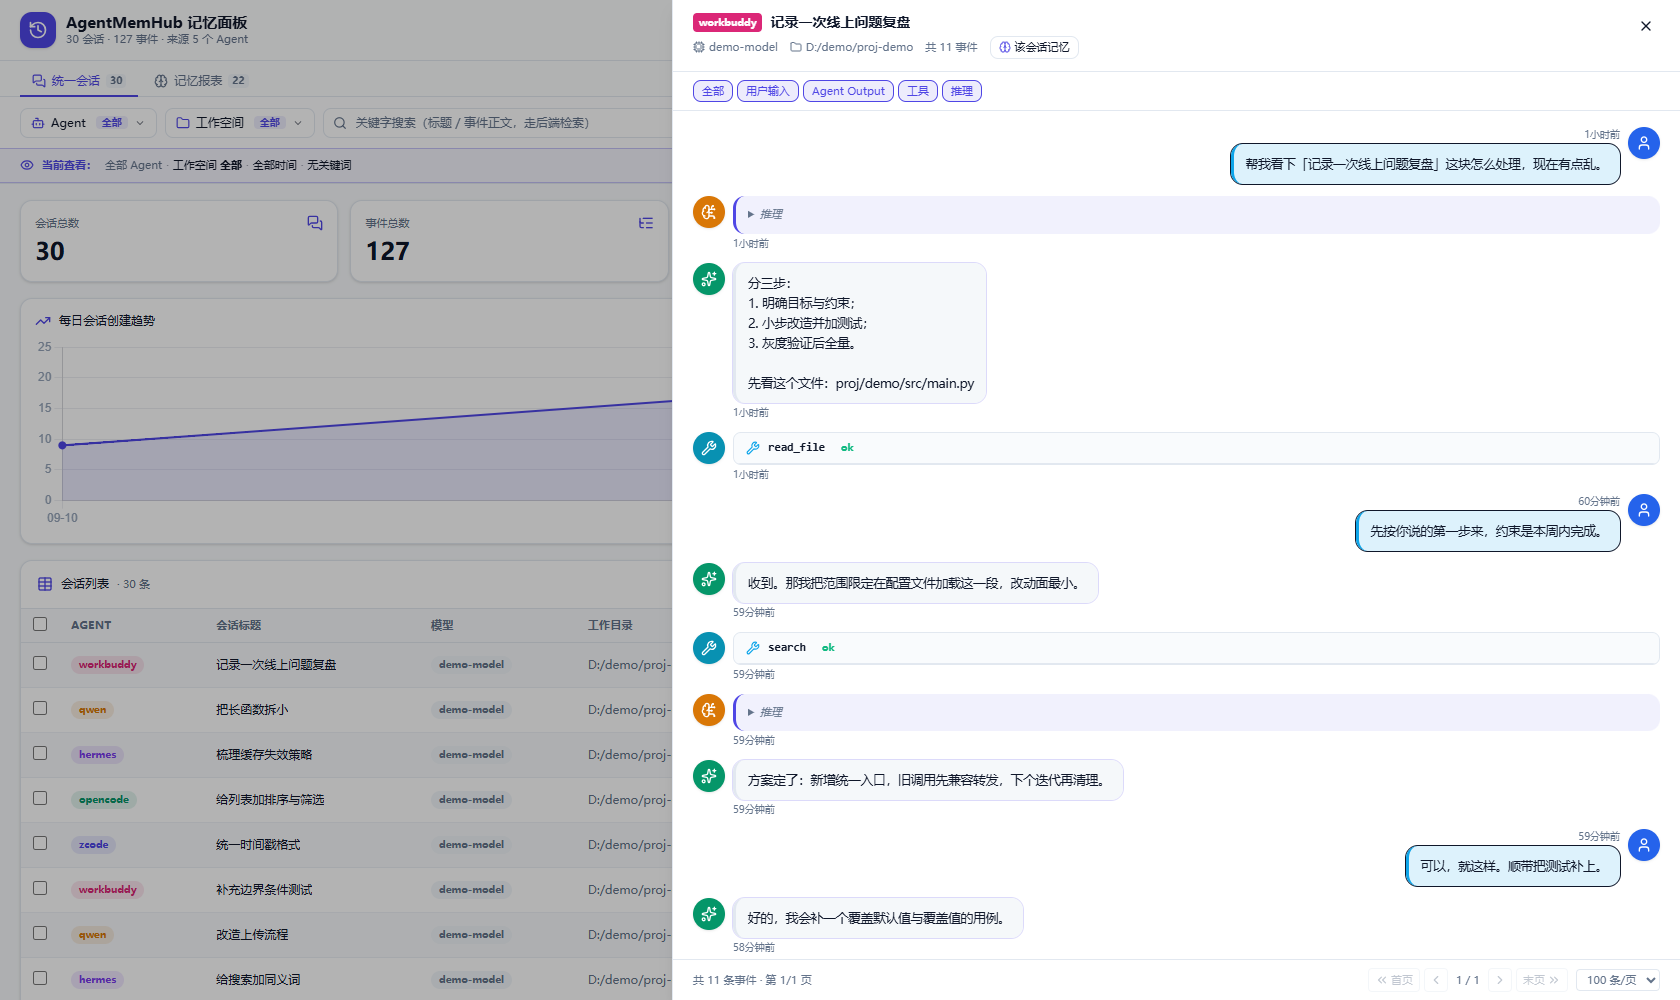
会话详情抽屉(用户消息/思维链/工具调用/代码补丁 全渲染,按记忆轮次分组)· 标题编辑与会话删除(真实写库)。
每行「🧠 查看该会话记忆」直达记忆报表并自动筛选该会话;标题修改与删除不会被后续 ingest 覆盖
(全局递增 session_uid + 用户修改保护 + 删除墓碑)。
记忆报表页:展示目前存放的全部记忆(蒸馏终稿 ∪ Agent 手动写入,每条带来源会话与轮次锚)。
memory_score 的"历史累加"分开:面板是当前表态(一 unit 一条),
累加均值会越点越钝、且无法取消,不适合人工按钮units.updated_at 覆盖率、
蒸馏投影一致性(投影数须等于有投影的活跃记忆数)、FTS 与向量索引一致性。
异常时列出可执行的处置建议,并提供一键「回收滞留投影」(幂等,与蒸馏流程
自动执行的是同一个函数)。同一套判据也能从命令行跑:scripts/health_check.py
(退出码 0/1,可挂 CI)。MCP(Agent 主动写入的原子记忆,无原始会话、会话列不可点)与采集来源;
每行标注「召回单元」与「有无原始会话」,避免误点失效链接记忆排除(会话级/轮次级「不写入记忆」)的后端能力保留(
memory_exclusions表、/api/*/memory-exclusion、CLI/MCP 均可用),面板 UI 自 P3 起下线——会话列表只做查看/删除/改标题。
设计要点:
agentmemhub/web/static/vendor//api/docsWebsiteDesign 设计稿改造而来,接口契约见 docs/ 与 /api/docs本项目本地运行、不上传任何数据。推送到公开仓库的部分严格脱敏:
Path.home() / 环境变量在运行时发现路径,不硬编码真实用户名或绝对路径.env.example(环境变量占位)、scripts/sensitive_scan.py(敏感扫描)exports/(已在 .gitignore,勿强制推送)[x] 统一事件模型 + SQLite 存储(FTS5)
[x] 8 个 Agent Adapter(含 src_id/turn_key 稳定锚与系统注入识别)
[x] Trae 适配器(最小可用:会话清单 + 每轮快照 diff + 项目记忆;对话正文等官方开放接口)
[x] 全量检索 + JSONL/Markdown 导出
[x] MemOS bundle 桥接(v2.0 起退役为回退路径)
[x] Web 仪表盘(FastAPI + 原生 JS,服务端分页、事件按需加载、真删改)
[x] 交互式控制台入口(start.bat / 无参数菜单)
[x] 记忆引擎一体化管理(MemOS 平移)(v2.0 起改为内置引擎)
[x] 统一配置体系(agentmemhub.yaml:全路径可配置)
[x] MCP 记忆网关(stdio / Streamable HTTP 双传输,供 ZCode/OpenCode 等 harness 检索/写入记忆)
[x] 记忆清洗(clean:删除系统注入事件,预览→执行并重建 FTS/计数)
[x] LLM 批量自动评分(score:三轴评估写价值分——入口已隐藏:实测多为 neutral/全跳过,质量把关改由蒸馏置信度 + 面板 👍/👎 承担;命令保留备查)
[x] 统一日志(<程序根>/logs/:web/cli/mcp/engine/tasks 分文件,面板可查历史;mcp.log 为 MCP 调用审计)
[x] MCP 写后即评(memory_score 工具 + save-memory Skill 独立仓:触发纪律/生效前提/逻辑归属)
[x] 导入数据质量(meta 幽灵轮剔除、纯工具轮标题兜底、恢复环境整源丢失修复)
[x] 增量同步架构(会话级清单对比 → upsert → watermarks 变更集贯通 clean/push;评分增量优先·定点读零全量枚举;cap 超限回退全量;默认数据目录收进项目内 database/)
[x] 内置记忆引擎 agentmemhub.rag(向量化 / 三路混合召回 / 价值评分,进程内直调、无独立服务)
[x] 引擎接缝 rag_bridge:原 MemOS 端点语义的进程内实现,MCP 五工具与面板契约零改动
[x] 一行配置回退 MemOS(backend.backend: memos),vendored memOS/ 保留
[x] 存量零丢失迁移(MemOS 2286 traces / 3836 feedback → 新索引)
[x] 记忆写入控制:会话级 + 轮次级排除(后端能力保留;面板 UI 自 P3 起下线,改用双标签页报表)
[x] 面板改造为「AgentMemHub 记忆面板」:双标签页(统一会话 / 记忆报表)、记忆报表(筛选·展开溯源·⭐加权·反馈·语义检索)、会话↔记忆双向跳转、标题修改与删除防 ingest 覆盖
[x] 批量嵌入性能优化:按文本长度分桶(bge-base 5.26 → 26 条/秒,全量 51 → 11.6 分钟)
[x] 多模型写入编排:小模型先跑完即可检索,高精度模型后台子进程并发补齐
[x] 统一配置 agentmemhub.yaml(模型注册/分桶/召回/写入策略/后端开关单文件)
[x] 记忆蒸馏(离线,四入口:Python/CLI/start.bat 控制台/面板):S0 窗口化切片 → S1 段级蒸馏 → S2 同会话合并 → S3 跨会话去重 → S4 投影为可召回 unit;幂等增量、脱敏、失败可重跑
[x] 权重体系:来源初始分 → 反馈演化(状态式可撤销)→ 手动加权(⭐ 两态锁定不衰减,有界 boost)
[x] MCP 调用审计:每次记忆调用(save / search / recent / stats / score)由服务端在唯一分发点自动留痕到 logs/mcp.log(每次两条 call/result + call_id,含参数摘要、耗时、成败),不依赖 Agent 记得写;Agent 可用可选参数 note 补充意图(为什么);查询走 scripts/mcp_log.py
[x] 带标签的版本锚点(v0-pre-rag 回滚点 / v1-rag-backend-only / v2.0)
[ ] 更多 Agent(Claude Code / Cursor / Gemini CLI / CodeBuddy)
[ ] 记忆折叠压缩(超长会话压缩、相邻轮折叠)
[ ] 存储扩展(单库增长的按 source 分片/归档;data_root 已参数化,见 watermarks 扩展点设计)
CLASSIFICATION EVIDENCE
系统优先读取 GitHub Topics,再与站内分类词典和词根规则比对。当前命中: 无有效分类标签。
deepseek-ai
DeepSeek Harness: Everything is a Plugin.

anywhere-labs
为 DeepSeek Harness (DSH) 插件生态打造的现代化桌面端解决方案。万物皆「插件」,桌面本身也是「插件」。

awesome-dsh-plugin
A curated list of plugins for DeepSeek Harness (dsh) · DeepSeek Harness 插件精选列表